Les lignes se retrouvent.
Appariez les éléments d’une collection avec leurs identifiants et un texte de secours. Comparez les valeurs correspondantes même si l’ordre des lignes a changé.
Vos factures, PDF et scans deviennent du JSON. Mesurez ce que votre IA a vraiment extrait. Comparez les modèles et les prompts aux réponses attendues, champ par champ.
Un prompt. Un échantillon. Des références vérifiées.
Conseil technique — septembre
{
  "invoice_number": "LUM-2026-0142",
  "supplier_vat": "FR12345678901",
  "issue_date": "2026-09-18",
  "currency": "EUR",
  "total_amount": 1140,
  "lines": [
    {
      "description": "Conseil technique — septembre",
      "quantity": 12,
      "unit_price": 95,
      "line_total": 1140
    }
  ]
}Une structure correcte ne prouve pas l’exactitude d’une extraction. Une décimale déplacée, une date inversée ou une ligne oubliée peuvent suffire à rendre le résultat inutilisable.
total_amountEXEMPLE FICTIFLe type est correct. La valeur ne l’est pas. Le benchmark permet d’inspecter cet écart.
Commencez avec un document.
Élargissez aux cas qui vous posent problème.
Collez votre prompt et un exemple JSON. JsonEval détecte la structure ; vous ajustez les types, les collections et les métriques dans le builder.
prompt.txt + exemple.jsonImportez un échantillon de documents. Ajoutez les réponses correctes ou faites-les préremplir par un modèle, puis relisez ce gold.
documents + goldChoisissez les modèles, confirmez l’estimation de coût et lancez le run. Comparez les champs, le coût et la latence avant de changer votre prompt.
benchmark + écartsDes scores entre 0 et 1.
Le détail derrière la moyenne.
| Champ JSON | Type | Ce qu’on vérifie | Métrique possible |
|---|---|---|---|
invoice_number | string | Le bon identifiant | exact |
supplier_vat | string | Le bon numéro de TVA | exact |
total_amount | number | Le montant et sa tolérance | number_tolerance |
issue_date | date | Une date normalisée | date_match |
lines[].description | string | Un libellé comparable | fuzzy / semantic |
lines[].quantity | number | Une quantité sur la bonne ligne | number_tolerance |
Appariez les éléments d’une collection avec leurs identifiants et un texte de secours. Comparez les valeurs correspondantes même si l’ordre des lignes a changé.
PDF natif ou pages rendues en images : créez des variantes séparées pour observer l’effet sur l’extraction, avec le même prompt.
Explorez les erreurs, le coût par document et la latence. Les prédictions conservées peuvent être rescorrées après une correction du gold.
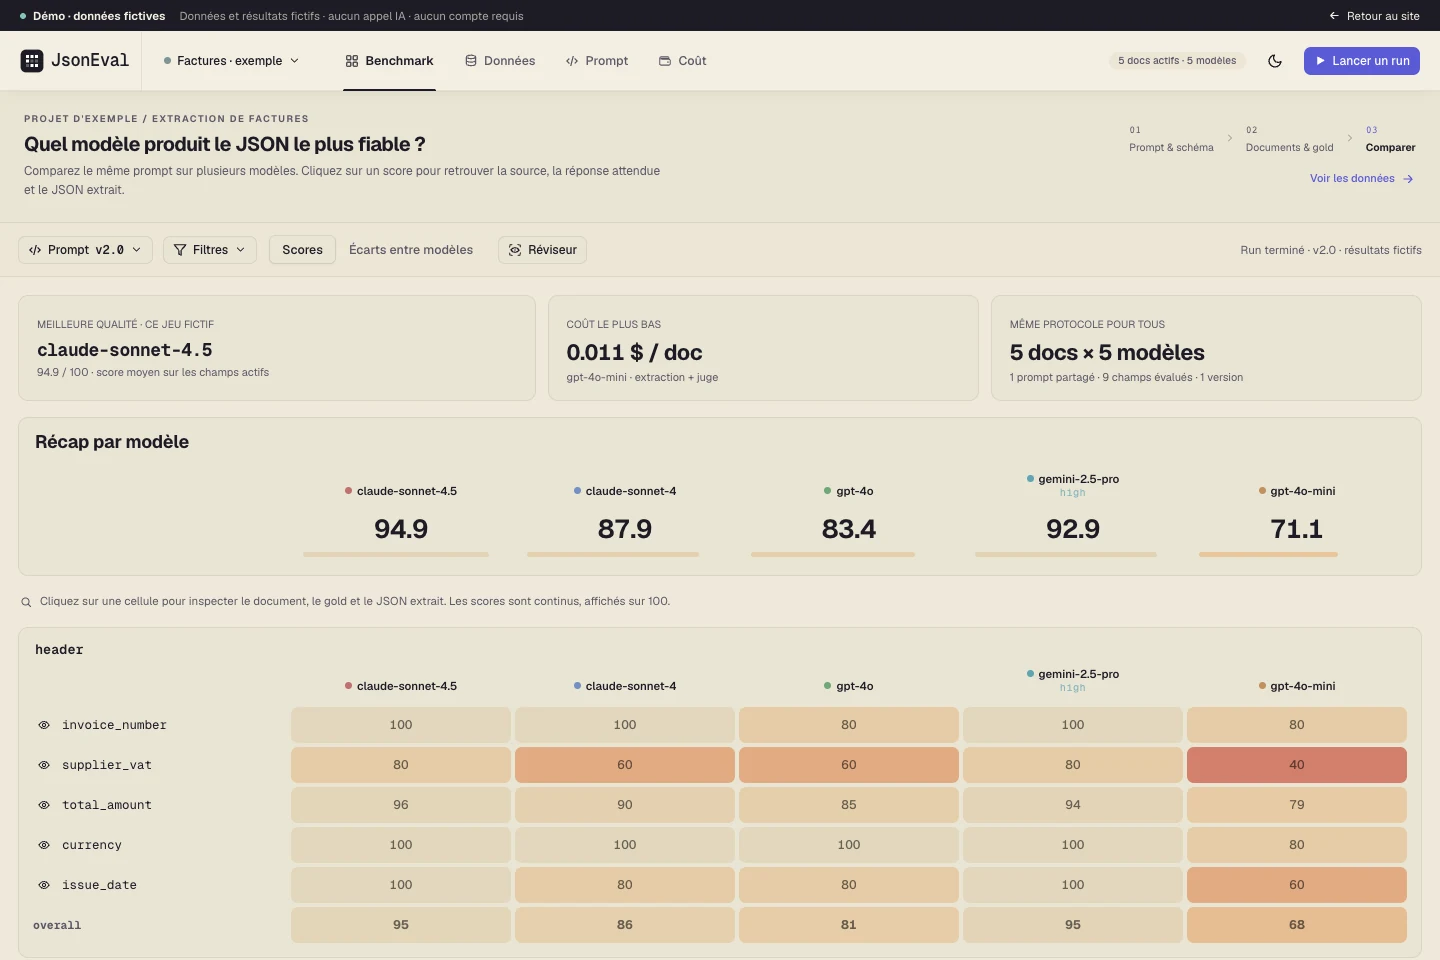
Le schéma définit ce que vous évaluez. Le gold définit la réponse attendue. Le run montre l’écart.
OCR Eval est le parcours d’évaluation de l’extraction documentaire par IA : document → LLM → JSON. Vous fournissez des PDF, scans ou images, un prompt, un schéma et des réponses attendues. JsonEval compare les modèles et les versions de prompt sur ces données. Ce parcours évalue les champs extraits ; il ne constitue pas un service OCR autonome ni une interface d’import de résultats de moteurs OCR tiers.
Oui. Les variantes permettent de comparer le transport du PDF natif et de ses pages rendues en images, avec un prompt partagé. Chaque variante apparaît séparément dans le benchmark. La prise en charge dépend du modèle et du fournisseur choisis.
Le gold est le JSON correct attendu pour chaque document. Vous pouvez importer ces valeurs, les saisir ou les préremplir avec un modèle de référence. Relisez-les avec le document et corrigez-les avant de vous appuyer sur les scores : une référence erronée fausse la comparaison.
Une collection regroupe les lignes à évaluer. Configurez les identifiants d’appariement et, si nécessaire, un champ texte de secours pour retrouver les éléments correspondants lorsque leur ordre change. Les champs sont ensuite scorés sur les lignes appariées ; les éléments absents deviennent visibles.
Les valeurs extraites sont comparées au gold avec la métrique choisie pour chaque champ : exactitude, proximité textuelle, sens, tolérance numérique ou dates. Les scores vont de 0 à 1 et les analyses présentent aussi le coût par document et la latence. Une estimation précède chaque action qui appelle un LLM ; le scoring sémantique peut faire appel à un juge facturé.
Explorez un projet fictif. Puis passez à vos propres documents.
Démo sans compte · Données fictives · Aucune inférence