NOTRE SPÉCIALITÉ
Factures → JSON
Le total TTC, la TVA et toutes les lignes. Comparez aussi vos scans difficiles.
invoice_numbertaxtotalitems[].quantityÉvaluez leurs sorties JSON sur les mêmes documents et références.
Trouvez le meilleur modèle pour votre extraction.
Préparez sans compte. Vous confirmez le coût avant toute évaluation par un modèle.
Un même atelier.
Des jeux d’évaluation qui vous ressemblent.
Le total TTC, la TVA et toutes les lignes. Comparez aussi vos scans difficiles.
invoice_numbertaxtotalitems[].quantityLa bonne intention, la bonne commande, la bonne échéance.
customerorder_idintentdue_dateEnseigne, devise, taxes et montant. Les petites lignes aussi comptent.
merchantdatecurrencytotalParties, dates et clauses. Distinguez ce qui est écrit de ce qui est inventé.
parties[]effective_datejurisdictionrenewal_clauseRéférences, quantités et adresses. Retrouvez les lignes, quel que soit leur ordre.
order_iditems[].skuitems[].quantitydelivery_addressPrix, unités, caractéristiques et variantes. Un catalogue mérite des données fiables.
skupricedimensionsvariants[]Importez un corpus représentatif et ses réponses attendues. Les emails et fiches produits s’évaluent à partir d’exports texte, PDF ou images.
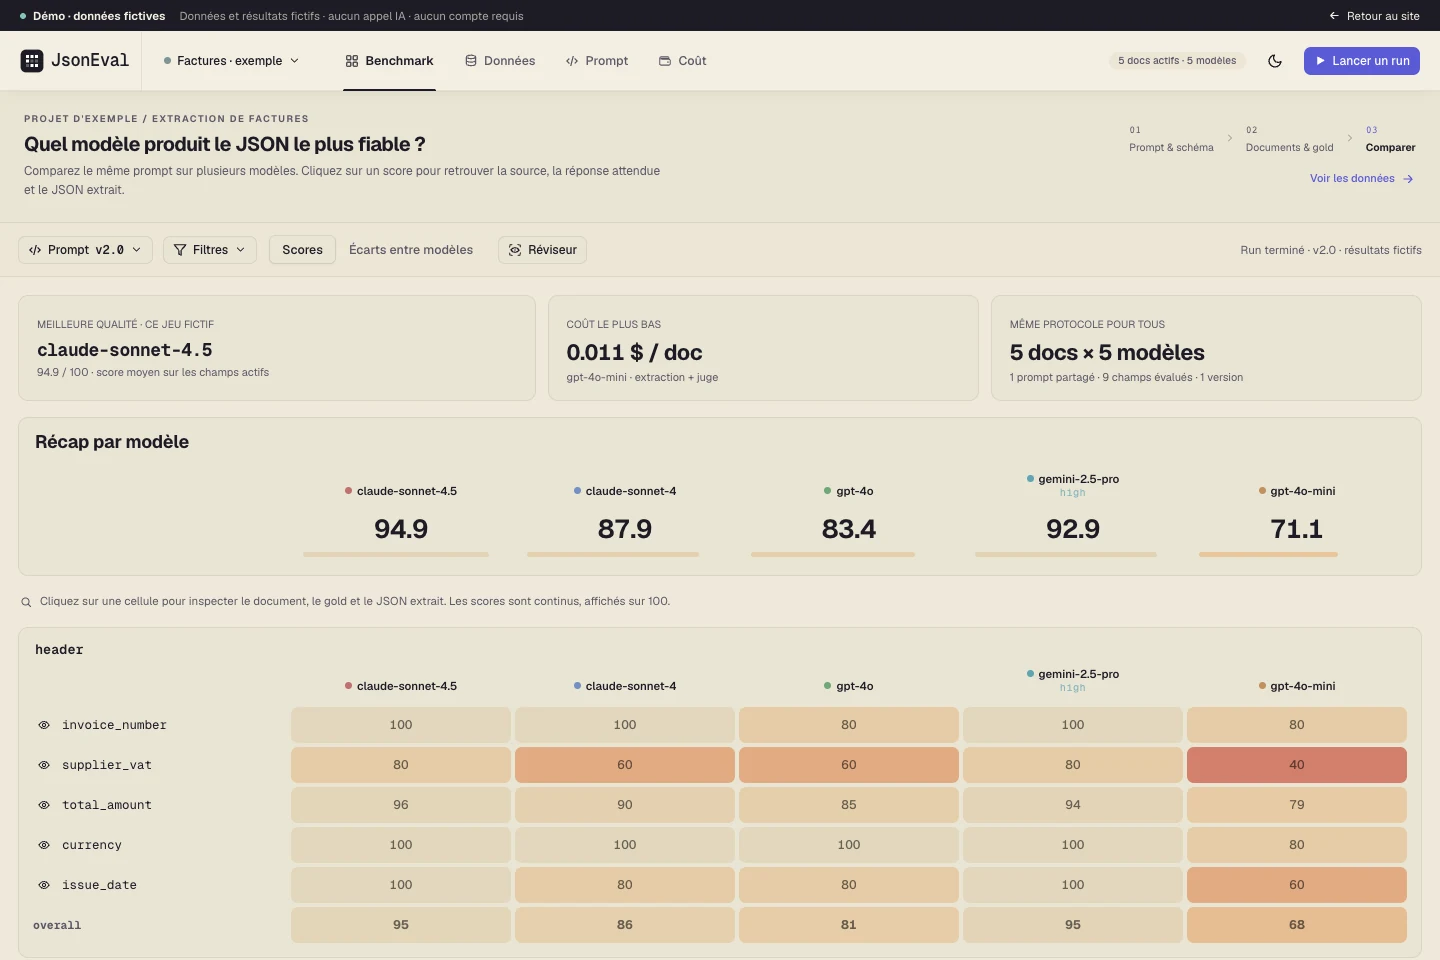
Un montant légèrement faux. Une date mal normalisée. Une ligne manquante. Un score global ne suffit pas : JsonEval montre où votre extraction s’améliore, et où elle régresse.
Vous apportez le contexte.
JsonEval organise la comparaison.
Créez un projet, collez votre prompt et un exemple de la structure JSON attendue. Le schéma peut aussi être proposé par l’IA, puis ajusté.
prompt.txt + exemple.jsonImportez un premier échantillon de PDF, images ou textes. Ajoutez les valeurs attendues, ou faites-les préremplir par un modèle et relisez-les.
documents + valeurs de référenceChoisissez vos modèles, confirmez l’estimation du coût, puis explorez les scores. Changez un prompt et voyez précisément ce qui évolue.
benchmark → prochaine itérationCommencez petit. Un premier échantillon permet de vérifier votre parcours. Élargissez ensuite le corpus pour mesurer la qualité sur des cas représentatifs.
DémarrerDe la préparation du corpus
à la prochaine version du prompt.
Illustrations et données fictives. Les scores ne représentent aucune performance réelle de modèle.
Comparez plusieurs LLM et versions de prompt sur les mêmes documents. Repérez les améliorations et les régressions, champ par champ.
Partez d’un exemple JSON, importez-le ou utilisez le builder visuel. Configurez la métrique de chaque champ, y compris les objets et collections imbriqués.
Exactitude, casse, proximité textuelle, sens, tolérance numérique, dates et appartenance à un ensemble. Des scores continus entre 0 et 1.
Importez vos PDF, images ou textes. Organisez vos documents en groupes et choisissez ceux qui participent à la comparaison.
Importez ou saisissez les valeurs attendues, ou amorcez-les avec un modèle. Relisez ce gold : c’est lui qui donne du sens aux scores.
Comparez les lignes d’un tableau même si leur ordre change. Identifiants et texte de secours aident à retrouver les éléments correspondants.
Passez de la heatmap au document, à la prédiction et à la valeur attendue. Le Réviseur aide à corriger et arbitrer les références douteuses.
Conservez vos itérations, comparez leurs résultats et choisissez la version active. Un même prompt pour tous les modèles d’une comparaison.
Regardez ce qu’un point de qualité vous coûte. Suivez extraction et juge, coût par document, latence et échecs facturés.
Les prédictions JSON sont conservées. Réévaluez-les après une correction du gold ou des règles ; un juge sémantique peut rester facturé.
Comparez un PDF natif avec ses pages rendues en images, ou imposez un fournisseur. Chaque variante apparaît séparément dans le benchmark.
Partagez le projet dans un workspace, discutez des valeurs et retrouvez l’historique des corrections. Gardez une référence commune.
La prédiction, la référence et le document.
Le même contexte pour toute l’équipe.
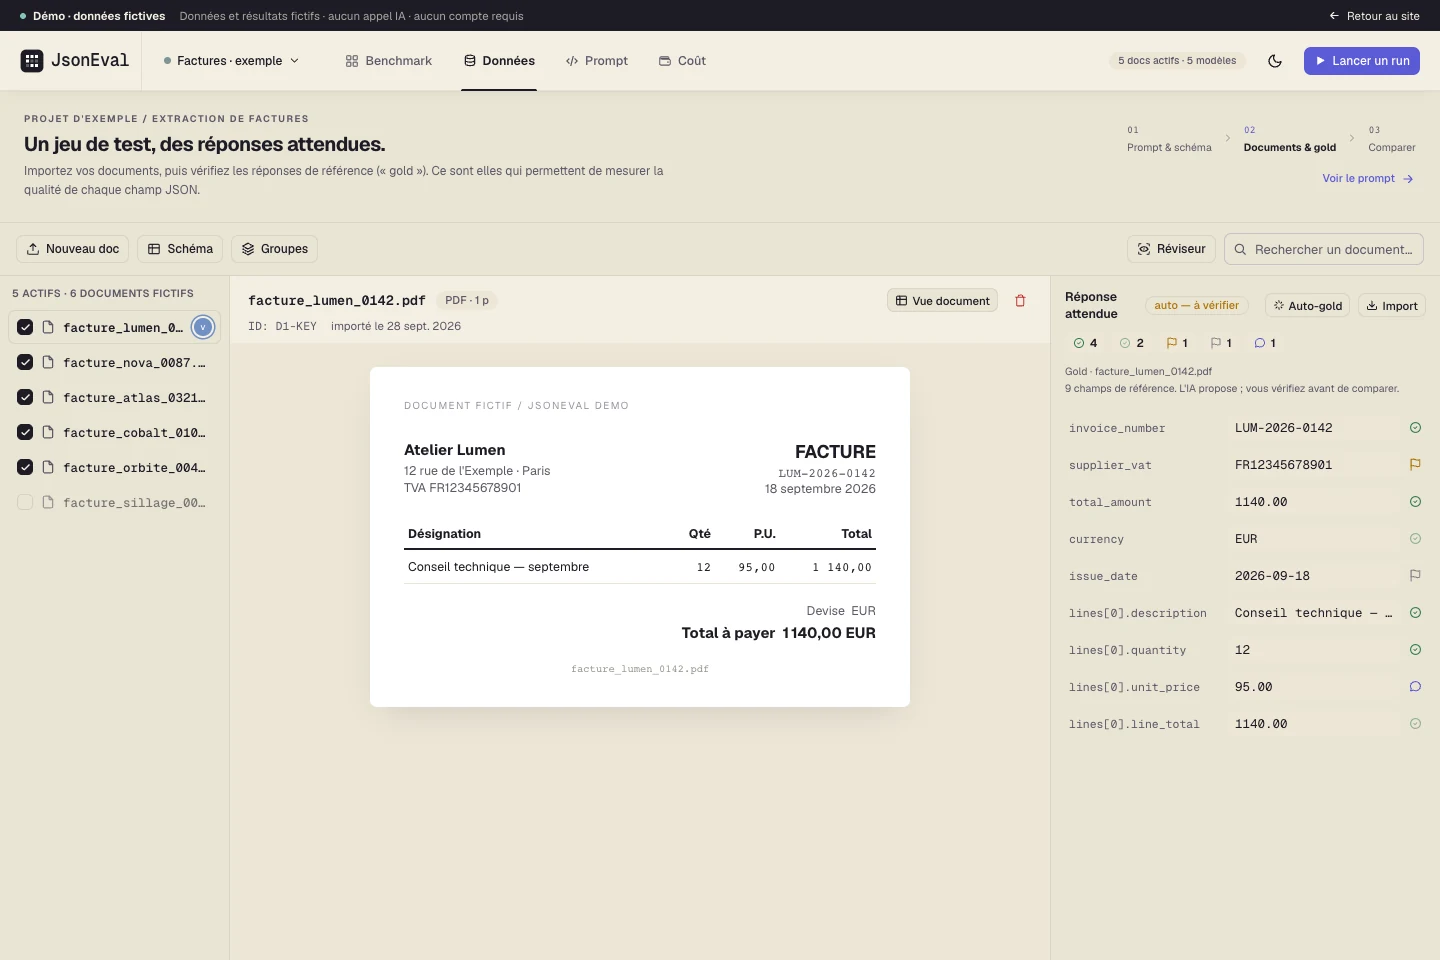
La réponse attendue se lit avec le document. Relisez, corrigez et discutez les valeurs douteuses.
Explorer les documents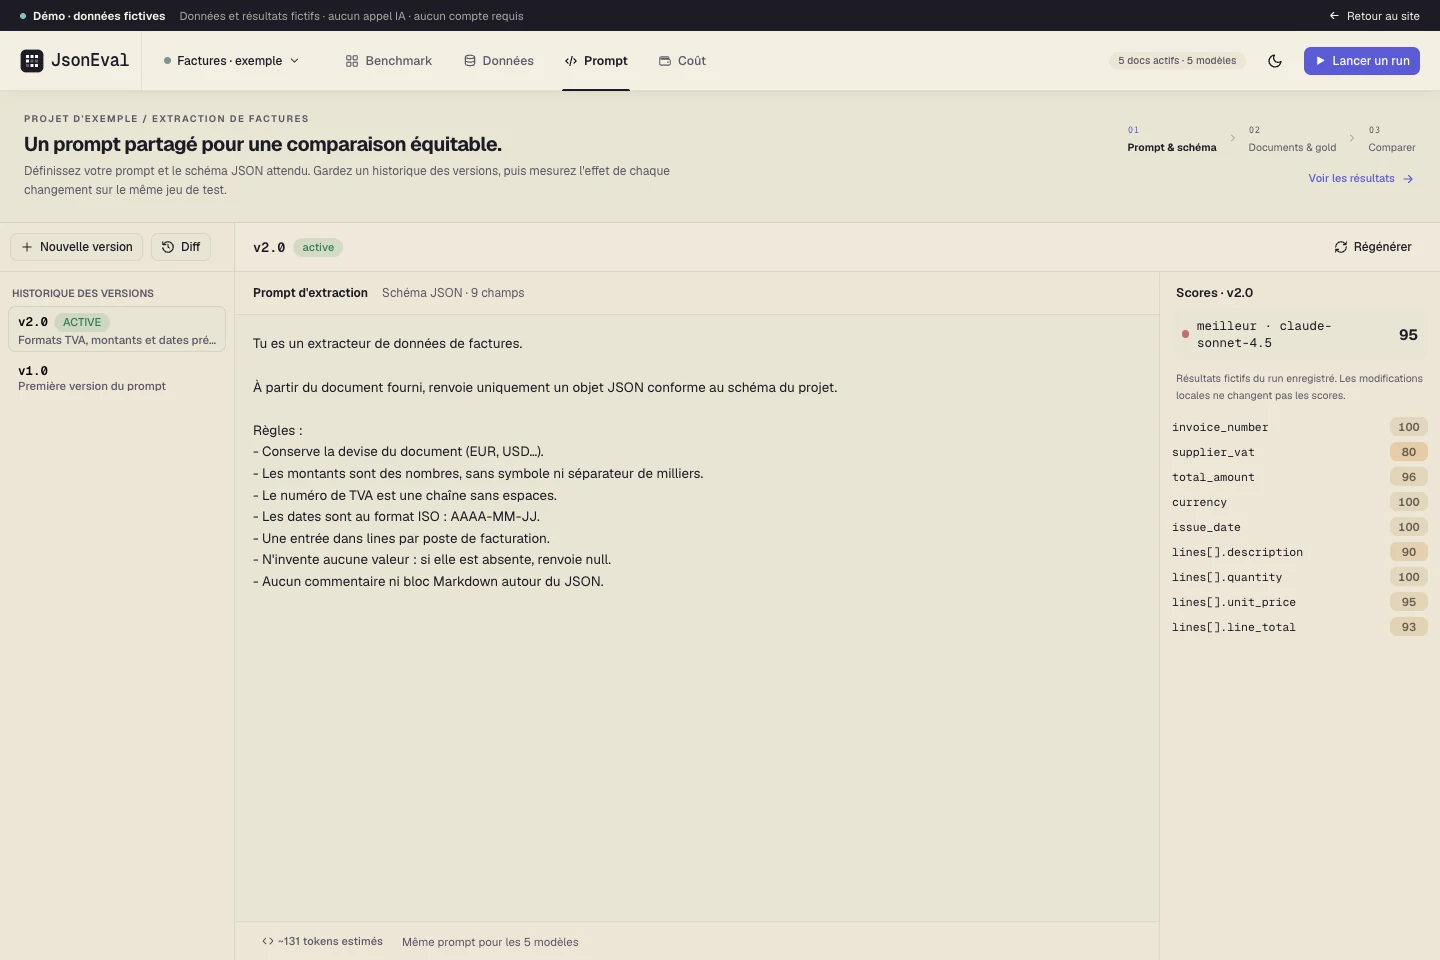
Une instruction devient une version. Comparez ses résultats avant d’en faire le prompt actif.
Explorer les promptsLancer et consulter les évaluations depuis le terminal, conserver le contexte des projets et préparer leur intégration à vos workflows de développement.
$ jsoneval evaluate
↳ projet · corpus · prompt · modèles
↳ scores par champ · coût · régressionsDonner à votre assistant de développement le contexte de vos évaluations : vos prompts, les champs qui régressent et les résultats à explorer ensemble.
« Quels champs régressent
avec mon nouveau prompt ? »
L’application web est disponible. La CLI, le plugin AI et l’intégration CI sont annoncés, pas encore publiés.
Une identité noire et blanche, un besoin décrit en quelques mots et une démo à explorer avant de créer un compte.
Voir les nouveautés BenchmarkPDF natif ou pages en images, fournisseur imposé : les variantes de modèle enrichissent la comparaison. Les analyses de coût gagnent en précision.
Voir les nouveautés DonnéesRetrouvez une valeur dans les documents et corrigez les répétitions depuis le Réviseur. Les références restent au cœur de l’évaluation.
Voir les nouveautésVous cherchez un outil pour évaluer les outputs JSON de vos requêtes AI ? Voici ce que JsonEval couvre, et ce qui arrive ensuite.
JsonEval est un outil d’évaluation des réponses JSON produites par des modèles d’IA. Il benchmarke l’extraction structurée : vous fournissez un prompt, un schéma, des documents et des réponses de référence, puis comparez les LLM et versions de prompt champ par champ.
Un validateur vérifie la structure et les types. Un JSON parfaitement valide peut pourtant contenir un montant faux, une ligne manquante ou une valeur inventée. JsonEval compare le contenu avec vos réponses attendues et attribue des scores par champ. Il complète la validation de structure.
Non. L’interface web guide la création du projet : prompt, schéma issu d’un exemple JSON, documents, valeurs de référence et première comparaison. Le builder visuel et l’amorçage assisté du gold aident à préparer le jeu d’évaluation.
Oui. JsonEval utilise le catalogue OpenRouter. Vous pouvez comparer plusieurs modèles sur le même corpus et le même prompt, ainsi que des variantes de transport PDF ou de fournisseur. Leur disponibilité dépend des modèles et fournisseurs concernés.
Le gold est la réponse attendue, votre vérité de référence. Chaque champ extrait est comparé à cette référence avec une métrique adaptée : exactitude, texte, sens, nombre, date ou ensemble. Les scores sont continus entre 0 et 1 ; ils ne remplacent pas la relecture humaine du gold.
La CLI et le plugin pour les outils AI sont prévus. Ils ouvriront l’évaluation depuis le terminal et les assistants de développement. Aujourd’hui, l’expérience disponible est l’application web ; aucune commande à installer ni intégration CI n’est encore publiée.
Non. La démo publique utilise uniquement des documents, réponses, scores et coûts fictifs, préparés à l’avance. Elle ne demande ni compte ni clé API et ne lance aucune inférence. Les interactions restent dans votre navigateur.
L’application affiche une estimation avant les actions qui appellent un LLM. Les analyses distinguent extraction et juge, et signalent les estimations. Les crédits prépayés, Stripe et la connexion d’une clé personnelle dans JsonEval sont encore prévus ; la démo ne représente pas une offre tarifaire.
Explorez un projet fictif. Puis passez à vos propres documents.
Démo sans compte · Données fictives · Aucune inférence